
Insights / Artigos técnicos
Guia de implementação do Cloudflare Vectorize: sincronize HTML público com segurança
Um guia detalhado para criar o corpus a partir do HTML público, manter o Pagefind disponível e operar a sincronização do Vectorize com segurança.
Sumário
- Primeiro: o que é o Cloudflare Vectorize?
- O que melhora ao adicioná-lo?
- Primeiro, sobreponha-a à pesquisa existente
- Conclusão: pesquisa fail-soft; sincronização e publicação fail-closed
- Decida primeiro estas quatro coisas
- Não substituir o Pagefind: dividir responsabilidades
- Criar o corpus a partir do HTML público, não dos rascunhos do CMS
- Tornar a sincronização incremental determinística com content hash
- Fixar o embedding model e as configurações do index como um contrato
- Fazer upsert, esperar a convergência e somente então executar delete
- Usar um index de substituição para uma grande exclusão ou mudança de modelo
- Desativar a pesquisa semântica deste site em Preview e fazer de Production o único destino de sincronização com privilégios altos
- Sincronizar em Production apenas o corpus do commit que está publicado
- Definir limites de custo e privacidade para a API pública de pesquisa
- Dar contratos distintos à pesquisa relacionada e ao chat de AI generativa
- Não misturar as responsabilidades das fontes de pesquisa
- Falhas reais e o que mudamos depois
- Registrar “implementado” em quatro etapas
- Configuração mínima para expandir a outro site
- Resumo
- Atualização de 6 de outubro de 2026: diferenciar zero resultados de uma resposta inválida
Para testar sincronização incremental, regenere o corpus com HTML público idêntico e confirme ausência de adições ou exclusões sem alterações. Depois teste uma pequena mudança e confira conclusão da mutação e busca com Cloudflare Vectorize: API. Defina limiares de exclusão separadamente dos limites do produto.
Atualização de 26 de setembro de 2026: A busca da Acecore Systems usa Cloudflare Workers AI BGE-M3 e um índice Vectorize dedicado de 1024 dimensões. Mudar o modelo exige reconstruir o corpus e o índice. O método de sincronizar o HTML publicado e manter o Pagefind continua válido.
Primeiro: o que é o Cloudflare Vectorize?
Cloudflare Vectorize é o banco de dados vetorial da Cloudflare. Ele armazena embeddings — representações numéricas das características e do significado de textos, imagens e outros dados — e encontra informações cujo significado é próximo de uma entrada. Como explica a visão geral oficial, ele pode servir para pesquisa semântica, recomendações, classificação e a camada de recuperação de futuras aplicações RAG.
A pesquisa comum por palavras-chave é excelente para encontrar rapidamente uma página que contém um nome de produto, nome próprio ou código de erro. O Vectorize ajuda quando as palavras usadas não correspondem exatamente. Uma pergunta como “quero melhorar meu site” pode encontrar uma página sobre suporte contínuo de operações web ou consultoria técnica, mesmo que a redação seja diferente.
O Vectorize não é, por si só, um chatbot que gera respostas. Ele é uma base de pesquisa que seleciona páginas públicas relevantes e suas URLs. Se a IA generativa for adicionada depois, esses resultados poderão ser a camada de evidências da resposta.
O que melhora ao adicioná-lo?
- Encontrar paráfrases e perguntas: os leitores não precisam conhecer os termos exatos usados no site para chegar a uma página próxima de sua intenção.
- Conectar conhecimento relacionado entre conteúdos: artigos, FAQs e páginas de serviço com textos diferentes podem ser descobertos por sua proximidade de significado.
- Fortalecer a pesquisa existente em vez de substituí-la: ao usá-lo apenas para uma ação explícita de “encontrar informações relacionadas” e manter a pesquisa por palavras-chave, a descoberta melhora sem reconstruir toda a UI.
- Reutilizar a camada de recuperação depois: retornar a página original e sua URL permite usar a mesma camada para respostas de IA com citações, artigos relacionados ou recomendações.
A pesquisa semântica não é mágica. Sua qualidade depende de um corpus público corretamente selecionado, de um embedding model adequado e da avaliação de resultados reais. Ela não deve substituir a pesquisa normal de nomes de produto ou códigos exatos.
Primeiro, sobreponha-a à pesquisa existente
Em uma adoção inicial, o padrão mais acessível é manter a pesquisa atual por palavras-chave e chamar o Vectorize apenas quando o leitor pedir explicitamente informações relacionadas.
- Usar Pagefind ou outra pesquisa comum para nomes de produtos, nomes próprios e termos curtos exatos.
- Usar a pesquisa relacionada do Vectorize para perguntas, paráfrases e temas próximos.
- Manter a pesquisa comum disponível se o embedding provider ou o Vectorize falhar.
Esse é o valor e o escopo que devem ser avaliados primeiro. O restante deste artigo mostra um procedimento reutilizável para sites Astro/Cloudflare Pages.
Uma primeira configuração prática: a Pages Preview comum desativa a pesquisa Vectorize deste site com
SEARCH_ENABLED=false. Os bindings de Vectorize/D1 e a sincronização automática ficam restritos a Production. Em Preview, confirme a interface de pesquisa e o fallback do Pagefind; em Production, sincronize somente o corpus criado a partir do commit publicado. As solicitações à API compartilhada de pesquisa em rede seguem um caminho separado. Assim, mudanças em teste e permissões amplas não chegam à pesquisa em produção.
Ao planejar a implementação do Vectorize, fica claro que apenas “criar embeddings e chamar query()” não é suficiente. Como criar o conteúdo pesquisável, como desativar a pesquisa Vectorize deste site em Preview enquanto se protege Production, como evitar exclusões em massa causadas por uma sincronização incorreta e como confirmar que as páginas publicadas realmente correspondem ao index? Na operação real, o projeto ao redor das chamadas da API do Vectorize é mais importante do que as chamadas em si.
Conclusão: pesquisa fail-soft; sincronização e publicação fail-closed
O princípio mais fácil de reutilizar foi separar a política de falha entre a pesquisa voltada ao usuário e a sincronização operada pela equipe.
| Alvo | Política em caso de falha | Motivo |
|---|---|---|
| Pesquisa interna normal | fail-soft | Continuar pesquisando com Pagefind mesmo se o Vectorize parar |
| API de pesquisa relacionada | fail-soft | Encerrar rapidamente o erro sem danificar os resultados da pesquisa normal |
| Geração do corpus | fail-closed | Não gerar se páginas, locale, contagem ou metadata estiverem incorretos |
| Sincronização do index | fail-closed | Não alterar se ambiente, IDs existentes, taxa de exclusão ou mutations não puderem ser confirmados |
| Ativação em Production | fail-closed | Ativar somente após a correspondência entre commit publicado e corpus e a convergência da sincronização e das mutations de Production |
Isso atende simultaneamente a duas condições: “a pesquisa do site continua disponível quando a pesquisa com AI falha” e “a sincronização não altera nem um único item quando há qualquer dúvida”.
Decida primeiro estas quatro coisas
Antes de escolher provider ou nome de index, responda a estas quatro perguntas. Elas tornam a arquitetura muito mais fácil de avaliar.
| Decisão | Opção simples para começar | Por quê |
|---|---|---|
| Objetivo do leitor | “Encontrar páginas relacionadas” | Em vez de gerar respostas imediatamente, você pode primeiro avaliar a qualidade da pesquisa. |
| Entrada da pesquisa | Vectorize no envio; Pagefind em caso de falha | Envio de dados e fallback ficam fáceis de entender. |
| Corpus de referência | HTML publicado | Rascunhos e telas administrativas não aparecem acidentalmente nos resultados. |
| Fluxo de publicação | Verificar a interface em Preview; sincronizar somente Production | Dados de teste e permissões não entram na pesquisa em produção. |
Depois de responder a essas quatro perguntas, escolha embedding provider, D1, R2 e uma futura geração de respostas de acordo com seus próprios requisitos.
Não substituir o Pagefind: dividir responsabilidades
O objetivo de adotar o Vectorize não era descartar a pesquisa existente.
O Pagefind cria um index estático a partir do HTML gerado e pode pesquisar no navegador. Ele é fácil de usar como pesquisa normal para termos explícitos, como nomes de produtos, serviços e nomes próprios, e não depende do estado de um embedding provider ou do Vectorize.
O Vectorize é adequado quando o termo pesquisado não corresponde exatamente ao texto ou quando queremos encontrar uma página a partir de um conceito relacionado. No entanto, ele exige a geração de embeddings e uma query ao Vectorize, o que também traz latência de serviços externos, erros e consumo a serem considerados.
Por isso, também separamos a interface.
- Não pesquisar durante a digitação; chamar a API somente ao enviar a consulta
- Executar o Pagefind se a pesquisa relacionada falhar ou não retornar resultados
- Definir um timeout curto na API
- Tratar falhas da API com o fallback do Pagefind
- Permitir que apenas a pesquisa relacionada seja interrompida por um kill switch
O modal de pesquisa atual não pesquisa durante a digitação. Apenas ao executar «Pesquisar» o termo é enviado à API de pesquisa deste site, como informa a interface. O Cloudflare Workers AI @cf/baai/bge-m3 converte o termo em embedding para compará-lo com as informações públicas do site no Vectorize. Se a pesquisa relacionada falhar ou não retornar resultados, o Pagefind é executado no navegador como fallback. Depois, o termo também pode ser enviado à API de pesquisa compartilhada da Acecore (acecore.net) para mostrar informações públicas de sites relacionados. A interface pede que não sejam inseridos dados pessoais ou confidenciais.
Com essa estrutura, o Vectorize amplia a experiência de pesquisa sem se tornar um ponto único de falha para toda a função.
- Classificar a resposta Distinguir resultados, zero resultado válido, falhas ou respostas não 2xx e dados malformados.
- Interface de busca do site O fallback estático do Pagefind pertence à busca do site; mantenha-o separado da base de uma resposta externa.
- Decisão sobre resposta externa Zero resultados não fundamentam a resposta. Em caso de falha ou dados inválidos, suspenda; o uso em produção não foi confirmado.
Criar o corpus a partir do HTML público, não dos rascunhos do CMS
A principal diferença entre os sites estava na escolha da fonte de verdade do conteúdo pesquisável.
Criar o corpus diretamente de rascunhos do CMS ou Markdown causa diferenças em relação às páginas realmente publicadas.
- Conteúdo marcado como
draftounoindexpode ser incluído - Páginas que apontam para um canonical externo podem permanecer
- Texto duplicado do layout e interfaces administrativas podem ser incluídos
- title, description e URL que aparecem somente após a conversão não são refletidos
- Os limites de locale ficam ambíguos em sites multilíngues
Por isso, lemos o HTML gerado após o build do Astro e criamos o corpus somente depois de aplicar as condições de publicação.
Em um site multilíngue, o primeiro corpus pode incluir, por exemplo, apenas páginas de um idioma escolhido que atendam às condições abaixo.
- Ter canonical same-origin
- Ter
langem japonês - Não estar marcada como
noindex - Não ser
/admin,/api, 404 ou uma página de confirmação de envio - Permitir a exclusão de elementos que não fazem parte do conteúdo, como
data-vectorize-ignoree navegação - Ter uma URL pública root-relative e title
Dividimos o texto em chunks com meta de 850 caracteres, máximo de 1,200 e overlap de 120 caracteres. Esses valores não são uma resposta universal; são parâmetros operacionais adotados para o tamanho das páginas e o texto em japonês deste caso. Em outro site, ajuste-os de acordo com a estrutura real dos documentos e a avaliação da pesquisa.
Tornar a sincronização incremental determinística com content hash
Se os vector IDs forem números sequenciais ou UUIDs gerados durante a execução, até o mesmo corpus produzirá IDs diferentes na próxima geração. Isso recalcula embeddings de texto sem alterações e exige a exclusão em massa dos IDs antigos.
Por isso, criamos SHA-256 a partir de locale, URL pública, número do chunk e texto, gerando deterministicamente o ID e a corpus version.
const identity = [locale, url, String(chunkIndex), text].join("\u001f");
const digest = sha256(identity);

const vector = {
  id: `v1-${digest.slice(0, 48)}`,
  text,
  metadata: {
    locale,
    url,
    chunkIndex,
    contentHash: digest,
  },
};
Durante a sincronização, comparamos os IDs esperados com os IDs atuais do index.
- Gerar embeddings e fazer upsert dos IDs que existem apenas no conjunto esperado
- Tratar IDs presentes nos dois lados como inalterados e fazer skip
- Considerar para exclusão os IDs que existem apenas no index
- Interromper antes de qualquer mutation se houver IDs fora do escopo gerenciado
v1-
Assim, o mesmo conteúdo público produz o mesmo corpus, facilitando a explicação do motivo de cada diferença.
Fixar o embedding model e as configurações do index como um contrato
Escolha o provedor e o modelo de embeddings conforme os idiomas, a qualidade da pesquisa, a latência e o custo. A Acecore Systems usa atualmente Workers AI @cf/baai/bge-m3 com um índice cosine dedicado de 1024 dimensões. Ao adotar outro modelo, verifique a saída real e migre para um índice separado para a nova configuração. Nunca misture vetores de dimensões diferentes no mesmo índice.
Mais importante do que o nome do modelo é manter o mesmo contrato nos quatro pontos abaixo.
| Local | Valor fixado |
|---|---|
| corpus metadata | model, dimensions e metric |
| Vectorize index | dimensions e metric |
| API de pesquisa | model e embedding length |
| Script de sincronização | model, dimensions e metric permitidos |
Como descrito em Create indexes da Cloudflare, dimensions e metric do index não podem ser alterados depois da criação. Se a documentação do modelo for ambígua, não crie o index por suposição: confirme a documentação atual e a saída real.
Ao usar metadata filtering, crie o metadata index antes de inserir os vectors. Os vectors já inseridos não passam a ser incluídos apenas porque um metadata index foi adicionado depois; é necessário fazer o upsert novamente.
Os limits do produto também mudam. Reconfirmado em 31 de julho de 2026, no Vectorize V2, o limite de upsert batch da Workers API é 1,000 e o da HTTP API é 5,000. O limite normal de topK é 100 e cai para 50 com returnValues: true ou returnMetadata: "all". Durante a implementação, consulte sempre os limits atuais e a client API.
Escolha conscientemente batches e valores de topK menores e seguros de observar, em vez de usar diretamente os limites máximos do produto. O limite do provider e um tamanho de batch que sua equipe consegue repetir e monitorar com segurança são decisões diferentes.
Fazer upsert, esperar a convergência e somente então executar delete
As operações insert, upsert e delete do Vectorize são assíncronas. Uma resposta de sucesso da API não significa que a mudança já esteja refletida nas queries.
Definimos a seguinte ordem para uma sincronização segura.
- Validar o corpus e a configuração do index
- Obter todos os vector IDs atuais com pagination
- Calcular os itens para upsert e os candidatos a delete
- Executar o upsert em batches
- Esperar até que o
mutationIdretornado alcanceprocessedUpToMutation - Executar o delete somente depois da convergência do upsert
- Confirmar também a convergência da mutation de delete
A Vectorize API da Cloudflare também declara que mutations são assíncronas. Não dependa apenas de um sleep por um número fixo de segundos; use o mutation ID para confirmar a conclusão.
Além disso, incluímos no script as seguintes condições de parada.
- O nome do index de destino não corresponde exatamente à allowlist do index de Production
- O processo tenta criar automaticamente um index de Production
- O valor de
--confirm-productionnão corresponde ao nome do index de destino - dimensions/metric diferem do contrato
- locale, URL, metadata ou content hash do corpus é inválido
- A quantidade de source pages ou de vectors excede o limite esperado
- O index existente contém IDs fora do escopo gerenciado
- Mais de 20% dos vectors existentes seriam excluídos
- O limite de retries ou o tempo de espera pela mutation é excedido
Mesmo uma exclusão em massa intencional é tratada em um procedimento de migração revisado separadamente, sem override no workflow normal. Ele nunca é permitido em um push normal ou schedule.
Usar um index de substituição para uma grande exclusão ou mudança de modelo
Uma exclusão acima de 20% não deve ficar na sincronização diferencial rotineira. Esses 20% não são um limite de produto da Cloudflare: são uma proteção operacional que interrompe o fluxo normal para revisão humana.
Quando um index existente teria 21,3% dos vetores removidos, não apagamos diretamente. Mudamos para esta sequência:
- Criar um index de substituição compatível com o novo contrato de modelo, dimensions e metric.
- Sincronizar integralmente o corpus publicado e verificar a convergência do conjunto de IDs e canaries de queries conhecidas.
- Trocar o binding de Worker ou Pages para o index de substituição.
- Verificar a API de busca de Production, o fallback de busca comum e o binding ativo.
- Excluir o index antigo somente com uma aprovação explícita separada.
Se houver um problema após a exclusão, defina primeiro SEARCH_ENABLED=false para parar apenas a busca relacionada e preservar a busca comum. Em seguida, recrie e sincronize integralmente o index de substituição, verifique as queries e troque o binding de novo. Excluir um index nunca deve ser a primeira ação de rollback.
Desativar a pesquisa semântica deste site em Preview e fazer de Production o único destino de sincronização com privilégios altos
Separar Preview e Production na fase inicial ajudou a identificar permissões e condições de parada. Porém, uma Pages Preview normal não precisa de bindings de Vectorize ou D1. A configuração atual mantém SEARCH_ENABLED=false: Preview serve para verificar o fallback do Pagefind após o envio e o layout. As solicitações à API compartilhada de pesquisa em rede são independentes dessa configuração. Bindings de Vectorize e D1, tokens de sincronização e o Production Environment ficam limitados a Production.
Separamos os seguintes elementos.
- Vectorize index
- Recursos auxiliares como D1
- Wrangler environment
- API token
- GitHub Environment
- concurrency do workflow de sincronização
- repository variable de ativação
- kill switch
Restringimos o token de sincronização a Vectorize Read / Write na conta Cloudflare de destino e o separamos das chaves de API usadas para outros fins. Production só pode ser executado a partir do main protegido e passa pelos reviewers do GitHub Environment.
Isso também envolve um trade-off operacional. Quando o Production Environment exige reviewer, uma sincronização iniciada por schedule também pode ficar aguardando aprovação. Antes de adicionar o cron, é preciso decidir se apenas a primeira publicação será aprovada, se toda sincronização periódica exigirá aprovação ou se haverá jobs separados.
Sincronizar em Production apenas o corpus do commit que está publicado
O main no GitHub e o commit atualmente publicado no Cloudflare Pages nem sempre são iguais. Logo após um push, o build pode ainda estar em andamento; se o deployment falhar, o commit anterior pode continuar publicado.
Por isso, colocamos um build marker no site publicado e verificamos o seguinte durante a sincronização de Production.
- O commit do marker é um Git SHA de 40 caracteres
- O commit existe no repository
- Ele é ancestral do
mainprotegido - É possível fazer checkout desse commit e gerar novamente o corpus
- A corpus version do marker corresponde ao resultado regenerado
- O mesmo commit continua publicado imediatamente antes da mutation
O critério de conclusão é um deployment do Cloudflare Pages conectado ao GitHub repository. Um artefato publicado temporariamente de forma local ou por Direct Upload não serve como referência para a sincronização em Production.
Isso evita divergências como “sincronizar um corpus novo em um site antigo” ou “mostrar nos resultados apenas o conteúdo de um commit cujo deployment falhou”.
Definir limites de custo e privacidade para a API pública de pesquisa
A API de pesquisa é um endpoint público que envia o texto digitado para um embedding provider. Além da precisão, seu projeto precisa considerar abuso, custo, logs e as URLs retornadas.
Uma API pública de pesquisa deve implementar ao menos os limites abaixo.
| Item | Exemplo implementado |
|---|---|
| method/formato | Aceitar somente JSON POST same-origin |
| body | Até 2KiB; interromper durante a leitura do stream mesmo sem Content-Length |
| query | 2〜160 caracteres depois da normalização NFKC |
| locale | Somente ja |
| rate limit | Limites por client e globais adequados a custo, tráfego e modelo de ameaça |
| interrupção | Desativar somente a pesquisa relacionada com SEARCH_ENABLED |
| query | Não armazenar a raw query em logs, corpus ou Vectorize metadata |
| URL do resultado | Permitir apenas URL pública root-relative e same-origin |
| erro | Retornar um code estruturado por etapa sem registrar o corpo |
Um UUID apenas no client não é um limite forte de custo, pois pode ser alterado pelo usuário. Combinamos uma client key derivada das informações de conexão da Cloudflare, um global limit e monitoramento de uso. Dependendo da escala e da ameaça, também podem ser considerados Turnstile, WAF e Durable Objects.
Nesta arquitetura, D1 é usado para rate limit, mas não é obrigatório para implementar o Vectorize. O mesmo vale para R2. Escolha conforme a origem do texto e onde o rate limit precisa ser armazenado.
Dar contratos distintos à pesquisa relacionada e ao chat de AI generativa
Uma pesquisa de «conteúdo relacionado» pode enviar o termo a um embedding provider somente depois de uma ação explícita e comparar o embedding com as informações públicas do site no Vectorize. Já um chat de AI separado envia a pergunta e, se necessário, o contexto da conversa a um serviço de respostas para gerar uma resposta.
Não se deve reduzir ambos a uma vaga «pesquisa de AI». Dados transmitidos, escopo das fontes, exibição de falhas, uso e explicações de privacidade devem ser projetados separadamente; um fallback da pesquisa Vectorize nunca deve ser enviado silenciosamente ao guia de AI.
Não misturar as responsabilidades das fontes de pesquisa
Sites, centrais de ajuda, políticas e bases de conhecimento internas têm responsabilidades diferentes. Defina antes a qual fonte cada tipo de pergunta pertence.
- Pesquisar informações públicas de produtos e serviços no corpus do site
- Buscar regras e procedimentos vinculantes em sua fonte oficial
- Não fazer fallback para uma fonte inadequada se o Vectorize falhar
- Vincular somente fontes realmente selecionadas como evidência
- Não inferir regras ou informações não confirmadas
Isso também é importante em RAG e chats de orientação. Quanto mais fontes pesquisáveis forem adicionadas, mais necessário é decidir previamente para onde enviar cada tipo de pergunta e o que não responder quando não houver informação.
Falhas reais e o que mudamos depois
Estes são problemas que tendem a se repetir e devem ser considerados desde o início.
| Sintoma | Causa | Próxima ação |
|---|---|---|
| Adicionar um binding não produz uma função de pesquisa | API, corpus, reindex, permissões e UI não foram projetados | Definir o contrato de pesquisa e o fluxo operacional antes de criar o index |
| dimensions são deduzidas ao criar o index | O nome do modelo foi usado sem confirmar a saída real | Verificar o embedding length real antes da criação |
| Vectors existentes não aparecem no metadata filter | Eles foram inseridos antes do metadata index | Criar primeiro o metadata index e fazer novo upsert dos vectors existentes |
| A query fica instável logo após a sincronização | A mutation é assíncrona | Aguardar a convergência com mutationId e informações do index |
| Há muitos embeddings recalculados e deletes | O vector ID muda a cada execução | Usar IDs determinísticos derivados de content hash |
| Um schedule fica parado em waiting | O Production Environment exige aprovação | Projetar em conjunto a sincronização periódica e a política de aprovação |
| Testes ou Git falham no Windows | Fatores do ambiente como spawn EPERM, lock ou cache |
Separar com comparação de baseline, Node version fixada e um novo npm ci |
| Um timeout da API é considerado falha do código | Falha temporária, payload incorreto ou atraso do provider | Testar novamente com o contrato correto e separar um resultado isolado da reprodutibilidade |
Também é importante não atribuir incorretamente problemas de dependência ou ambiente à mudança do Vectorize. Confirme se o mesmo erro aparece no baseline anterior à alteração e separe falhas do código de falhas do ambiente.
Registrar “implementado” em quatro etapas
Em artigos e relatórios de conclusão, separar os estados abaixo reduz mal-entendidos.
| Estado | Exemplo de condição de conclusão |
|---|---|
| Implementado | API, corpus, script de sincronização e UI existem na branch |
| Validado localmente | build, typecheck, testes de contrato e dry-run concluídos |
| Verificado em Preview | Fallback do Pagefind após o envio e UI de pesquisa verificados |
| Em operação em Production | Commit publicado sincronizado, convergência das mutations, API e procedimento de interrupção confirmados |
Registre esses estados separadamente também em relatórios de conclusão e notas de versão. Assim, código existente e uma operação de produção realmente segura não serão confundidos.
Registrar não apenas o número de testes concluídos, mas também o que ainda não foi verificado, é a informação operacional mais útil para a próxima pessoa responsável.
Configuração mínima para expandir a outro site
Ao aplicar a solução em outro site Astro/Cloudflare Pages, a configuração mínima se parece com o fluxo abaixo.
Astro build
  -> HTML público
  -> Pagefind index
  -> Vectorize corpus (reflete locale / canonical / noindex)

Cloudflare Pages Function
  -> input validation
  -> Cloudflare Workers AI (@cf/baai/bge-m3)
  -> Vectorize query
  -> retorna apenas URLs públicas

GitHub Actions
  -> resolve o commit publicado
  -> regenera o corpus
  -> sincroniza somente o index de Production incluído na allowlist
  -> executa delete após a convergência do upsert
  -> registra a corpus version

Pages Preview
  -> SEARCH_ENABLED=false
  -> verificar o fallback do Pagefind após o envio
Não é necessário incluir geração de respostas por LLM desde o início. Primeiro, crie uma pesquisa que “retorne páginas relacionadas com segurança” e possa ser avaliada. Mesmo ao acrescentar geração de respostas, trate o texto obtido, as URLs que podem ser citadas e as condições em que não se deve responder como contratos separados.
Resumo
A parte difícil da implementação do Cloudflare Vectorize não é a nearest-neighbor query em si.
O que incluir no index como informação pública, como identificar chunks sem alterações, como impedir uma sincronização incorreta, como corresponder ao commit publicado e como preservar a pesquisa normal durante uma falha: esse projeto operacional define a qualidade quando a solução é expandida para outro site.
Nossa conclusão é simples.
- Manter o Pagefind como fallback da pesquisa relacionada
- Usar o Vectorize para a pesquisa relacionada após o envio
- Criar o corpus a partir do HTML público
- Gerar ID e version de forma determinística com content hash
- Desativar a pesquisa semântica deste site em Preview e limitar Vectorize, D1 e permissões de sincronização a Production
- Tornar a pesquisa fail-soft e a sincronização e publicação fail-closed
- Registrar “implementação”, “validação local”, “verificação da interface em Preview” e “Production” como estados diferentes
Com essas fronteiras definidas desde o início, fica mais fácil operar o Vectorize não como uma função isolada de AI, mas como uma base de pesquisa que pode ser atualizada continuamente.
Atualização de 6 de outubro de 2026: diferenciar zero resultados de uma resposta inválida
Uma busca sem correspondências é diferente de uma falha na consulta, de uma resposta HTTP que não seja 2xx ou de um formato de resposta inválido. Em uma alteração anonimizada do fluxo de respostas, falhas de consulta e respostas inválidas deixaram de ser tratadas como uma busca confirmada para então gerar uma resposta pública. O fallback da interface de busca para o Pagefind estático também é separado da decisão de enviar externamente uma resposta baseada em fontes.
Mesmo uma busca normal com zero resultados não garante que exista uma resposta fundamentada em evidências. A geração do conteúdo, a verificação antes do envio e a aprovação operacional são limites distintos. A relação entre o estado da conversa e as promessas que podem ser cumpridas é descrita em Salvaguardas para respostas de IA.
Essa condição de parada em caso de falha na consulta foi confirmada no código corrigido e na revisão do PR. Os registros não permitem confirmar a implantação em produção desse caminho nem sua aplicação a respostas reais; ele não é apresentado como funcionalidade em operação.
Vectorize rollout
Do HTML publicado à pesquisa relacionada segura
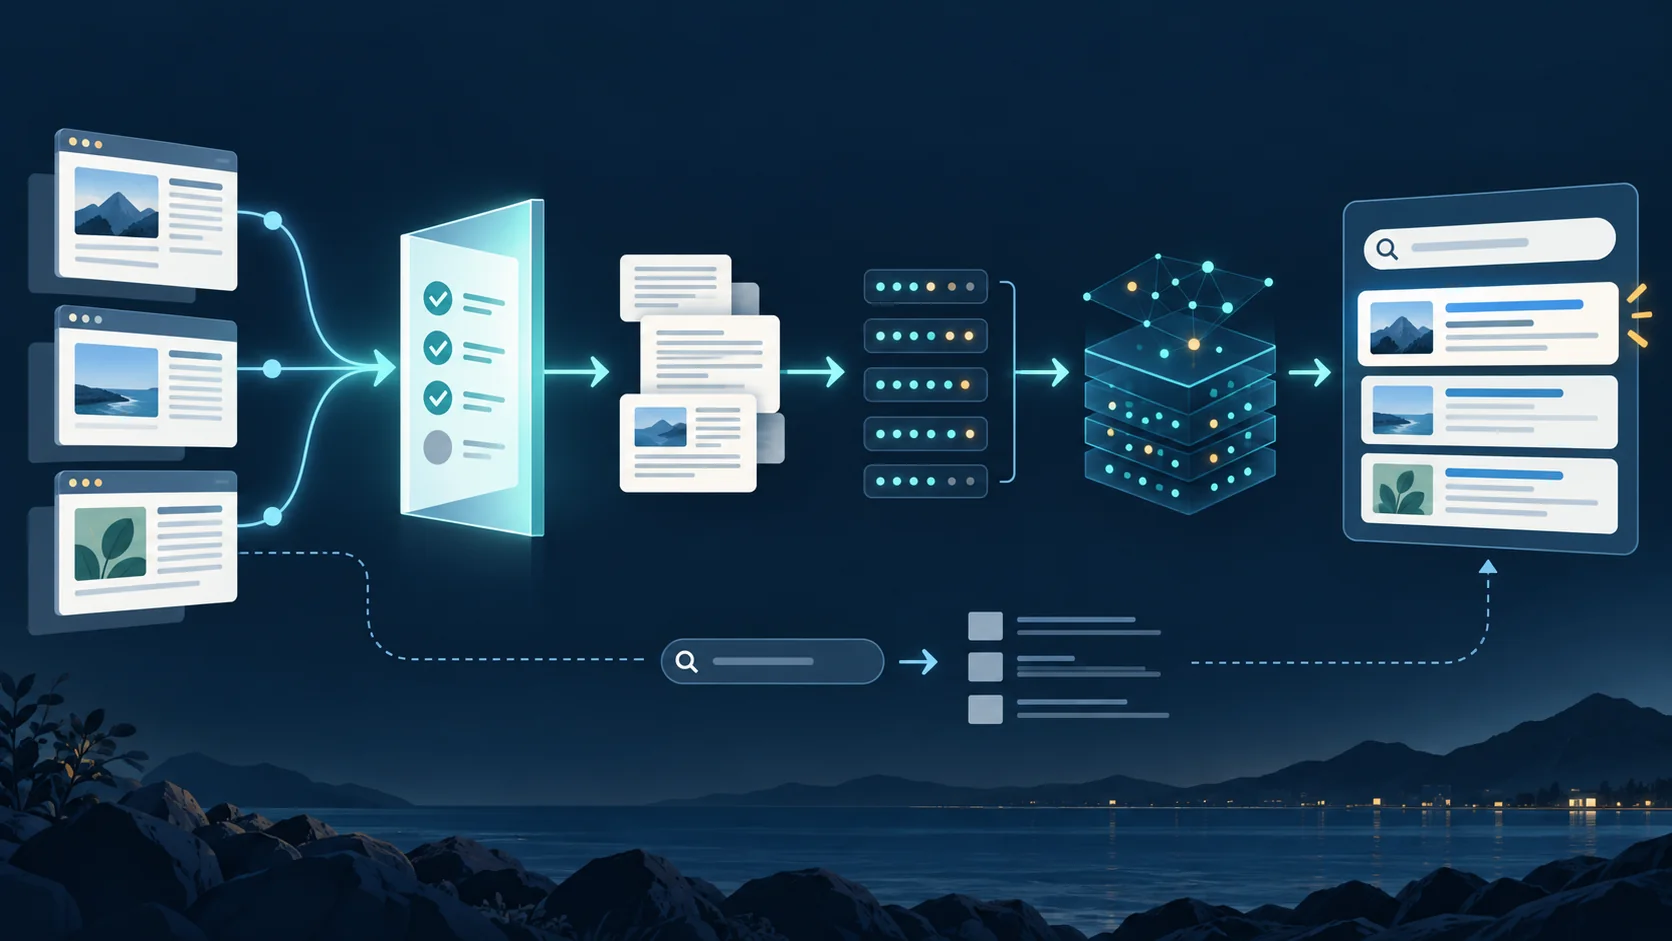
Em vez de inserir diretamente a fonte de edição, usamos como referência para a sincronização o HTML que realmente será publicado e o commit já implantado.
Fazer o build do HTML público
Gerar HTML estático que reflita canonical, locale e noindex.
Criar o corpus de forma determinística
Dividir o texto em chunks e adicionar IDs derivados de content hash e metadata para auditoria.
Verificar a interface em Preview
Manter a pesquisa semântica desativada ali e verificar o fallback do Pagefind após o envio e o aviso visível.
Sincronizar o commit publicado em Production
Comparar o build marker com a corpus version e ativar somente depois da convergência das mutations.
Pesquisa e sincronização exigem políticas diferentes em caso de falha
Depender de Vectorize para tudo
- Se AI, Vectorize ou D1 parar, toda a pesquisa interna deixa de funcionar
- A diferença entre o rascunho do CMS e a página publicada aparece diretamente nos resultados
- Uma configuração incorreta do script de sincronização pode alterar outro ambiente ou um grande número de vectors
- É fácil considerar a implementação concluída assim que o código é merged
Pesquisa fail-soft + sincronização fail-closed
- Tentar o Vectorize ao enviar a consulta e recorrer ao Pagefind em caso de falha ou ausência de resultados
- Criar o corpus a partir do HTML público, refletindo canonical, noindex e locale
- Validar a allowlist de Production, a taxa de exclusão, o commit publicado e a conclusão das mutations antes e depois da sincronização
- Registrar implementação, validação local, verificação da interface em Preview e operação em Production como estados diferentes
- Encontrar mais que termos exatos
- Pesquisa por significado
- Pagefind mais Vectorize
- Dois caminhos de pesquisa
- Pesquisar o que os leitores veem
- HTML publicado
- Verificar antes de publicar
- Introdução gradual
Ajuda com perguntas, paráfrases e páginas de tema relacionado.
A pesquisa por palavras-chave continua disponível e o Vectorize a complementa de modo seletivo.
O index acompanha as páginas realmente publicadas, não rascunhos do CMS.
Interface, corpus e sincronização recebem limites de segurança próprios.
Verificações antes de implementar no próximo site
- Manter a pesquisa por palavras-chave existente e preservar o caminho de pesquisa quando o Vectorize estiver indisponível
- Comparar a saída real do embedding model com dimensions/metric do index
- Gerar o corpus a partir do HTML público e excluir noindex, canonical externo e páginas administrativas
- Usar IDs derivados de content hash para não recalcular embeddings de chunks sem alterações
- Desativar a pesquisa semântica deste site em Preview e limitar Vectorize, D1 e permissões de sincronização a Production
- Confirmar a conclusão do upsert antes do delete e exigir aprovação explícita para exclusões em massa
- Definir body, query, locale, origin, rate limit e kill switch na API de pesquisa
- Sincronizar em Production somente deployments cujo commit publicado corresponda à corpus version
- Registrar separadamente implementado, validado, verificado em Preview e em operação em Production
Páginas relacionadas
- Entender primeiro os papéis de Vectorize e RAGUma introdução curta à pesquisa semântica, ao RAG e às condições necessárias para respostas com fontes.
- Documentação oficial do Cloudflare VectorizeConsulte as especificações atuais de index, binding, query e metadata filtering.
- Limits atuais do VectorizeOs limites de batch, topK, metadata e quantidade de vectors podem mudar; confira-os novamente durante a implementação.
- Arquitetura completa de sites Astro + CloudflareUm artigo que organiza em quais camadas colocar HTML estático, Pages Functions, D1 e pesquisa.
Perguntas frequentes
O Pagefind se torna desnecessário depois de instalar o Vectorize?
Não o removemos. Dividimos as funções: Pagefind é a pesquisa normal de baixa dependência, criada a partir de HTML estático; Vectorize é a pesquisa auxiliar para encontrar paráfrases e conceitos relacionados. Assim, a pesquisa normal continua disponível mesmo se AI ou Vectorize falhar.
D1 ou R2 é obrigatório para implementar o Vectorize?
Não. O D1 pode, por exemplo, controlar o rate limit da API de pesquisa, mas não é um armazenamento obrigatório do Vectorize. O local do texto original também deve ser escolhido conforme os requisitos, entre HTML publicado, JSON, D1, R2 e outras opções.
Como gerenciar o embedding model e as dimensions na implementação atual?
Model, dimensions e metric são um contrato compartilhado entre corpus, index, API e sincronização. Nunca misture vectors com dimensions diferentes no mesmo index. Como a configuração do index não pode ser alterada depois da criação, confira a especificação oficial atual e o shape real da saída antes de criar o index.
Em que momento a implementação é considerada concluída?
Não consideramos merge ou testes locais suficientes. Em Preview verificamos Pagefind e o fallback da interface; em Production verificamos a correspondência entre commit publicado e corpus, a sincronização do index, a convergência das mutations, a pesquisa relacionada, o rate limit e o procedimento de interrupção antes de registrar a operação.